把 GitHub 仓库当网盘:Contents API 的乐观并发与空目录
写操作必须串行,因为它是乐观并发
Contents API 更新与删除文件时,必须携带文件当前的 SHA。
于是每一次写都是「读 SHA → 提交」的读-改-写流程:两个任务同时读到同一个旧 SHA,
后提交的那个必然拿到 409 Conflict。
这里没有事务可用,能做的是把写操作排队:
/// 写操作串行化。上传/删除都是「先读 SHA,再提交」的读-改-写流程,
/// 并发提交会让读到的 SHA 过期,从而触发 409 冲突。
/// 用静态信号量把同进程内所有 provider 实例的写操作排队执行;
/// 只读操作(校验、列举、下载)不加锁,不受影响。
private static readonly SemaphoreSlim WriteLock = new(1, 1);
静态是关键字:锁的范围要覆盖同进程内所有 provider 实例,只锁实例等于没锁。 只读操作不进锁,否则列举一次目录会把整个上传队列堵住。
冲突策略给了三种,各有适用场景:
| 策略 | 行为 | 适用 |
|---|---|---|
Overwrite |
带已有 SHA 覆盖 | 同步本地目录 |
Fail |
立刻报「文件已存在」 | 不想误覆盖时 |
AutoRename |
依次试 -1 … -50,都撞了用 Unix 秒时间戳 |
批量上传 |
边界要写清楚:这把锁只覆盖当前进程。GitHub 网页、命令行、另一台电脑依然可能在你读 SHA 之后改文件; 代码收到 409 后不会自动重读 SHA 重试 —— 那是下一步该补的东西。
Base64 上传决定了内存成本,也解释了为什么没有断点续传
var bytes = await File.ReadAllBytesAsync(request.LocalPath, cancellationToken);

var payload = new Dictionary<string, object?> {
    ["message"] = commitMessage,
    ["content"] = Convert.ToBase64String(bytes),
    ["branch"]  = branch,
};
if (existingSha is not null) payload["sha"] = existingSha;
整个文件先完整进 byte[],Base64 又涨三分之一,再变成 JSON 字符串、再进 HTTP body ——
一个 100MB 的文件在这一路上远不止 100MB 的内存。
也正因为 Content 是一个完整字段,分块上传和断点续传在 Contents API 上根本无从实现:
没有 Range / Content-Range / 206 Partial Content 的对应物,重试就是从头再来一遍。
README 里写的建议上限是 100MB。真要做大文件,路是 Git Data API 或 Git LFS, 而不是在 Contents API 上硬补分块。
空目录:用一个占位文件补 Git 的模型差
Git 只存文件,不存空目录。网盘工具如果直接映射 Git 树, 用户新建的空目录会立刻消失,目录里文件删光之后目录也会消失。
private async Task EnsureKeepFileAsync(string folder, string branch, CancellationToken ct) {
    var key = $"{branch}\n{folder}";
    if (_ensuredFolders.Contains(key)) return; // 同一目录只补一次
    // ... 写入空 .gitkeep
}
三个配套决定:
- 上传整个文件夹时按本地结构递归,每一级目录都补一个
.gitkeep; - 于是「一个文件都没有的子目录」也能被建出来;
- 列表里永远不显示
.gitkeep—— 它是实现细节,不是用户的文件。
副作用要认:空目录的存在以本地记录为准,在别处(网页、命令行)删掉的空目录, 要等一次刷新才会消失。空目录本来就是边缘情况,可以接受。
外链只认公开仓库
上传成功后给的外链是 raw.githubusercontent.com 或 jsDelivr,两者都匿名可读 ——
前提是仓库本身公开。用私有仓库也能上传,但那时候的外链别人打开只会看到 404。
| 外链形式 | 适用 | 说明 |
|---|---|---|
| raw.githubusercontent.com | 默认 | 官方直链,国内偶尔不稳定 |
| jsDelivr | 需要加速时 | CDN 缓存,更新有几分钟延迟 |
| 自定义模板 | 自建镜像 | 模板里填 {owner} / {repo} / {path} |
现在的形态
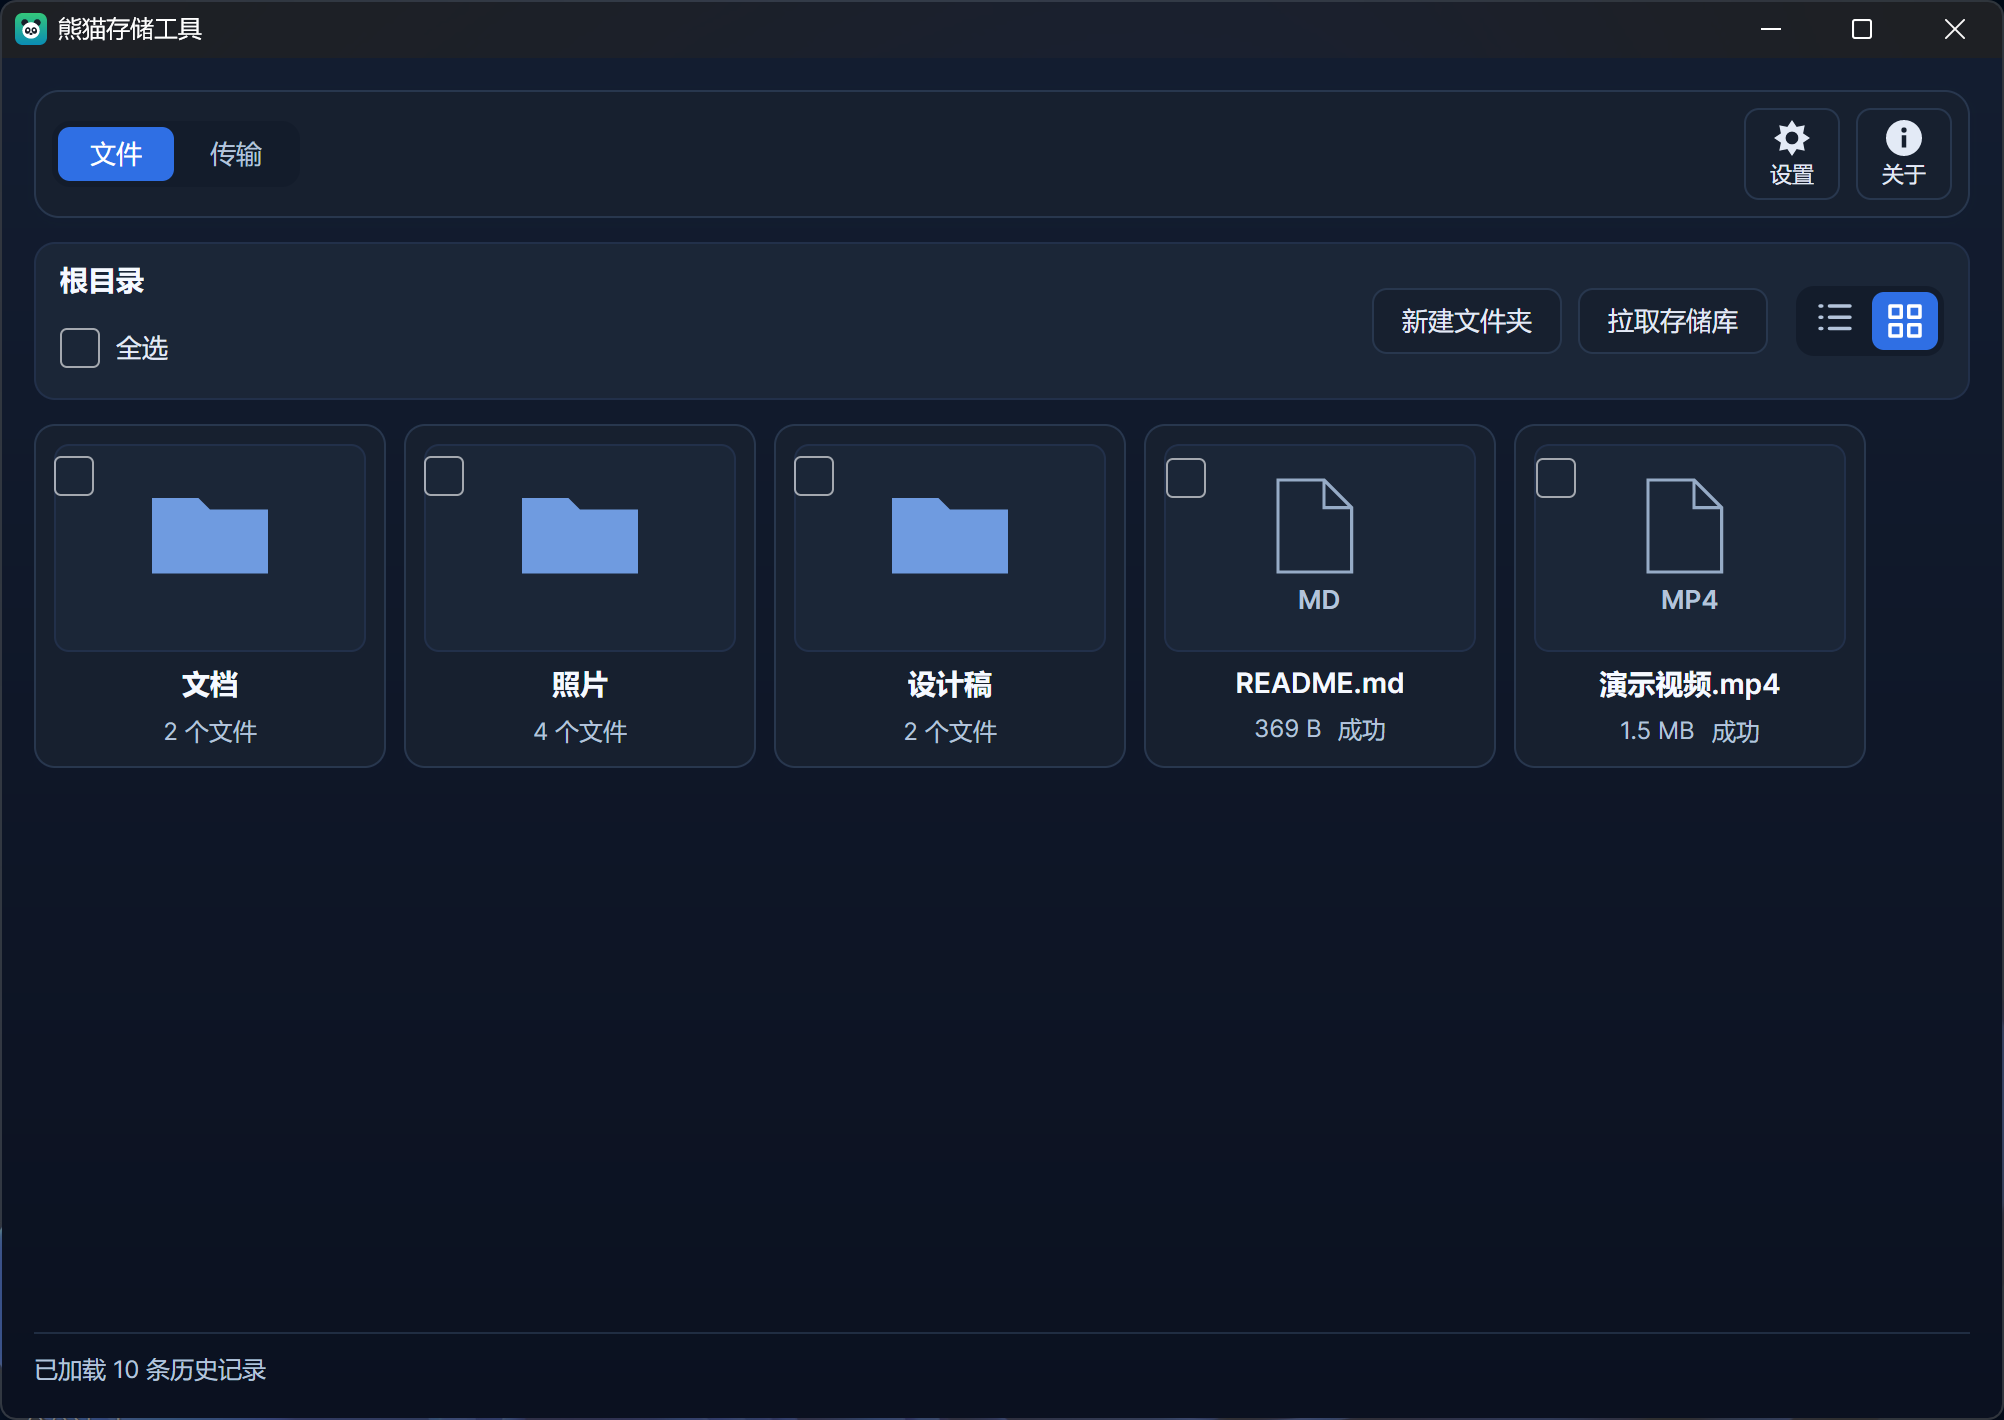
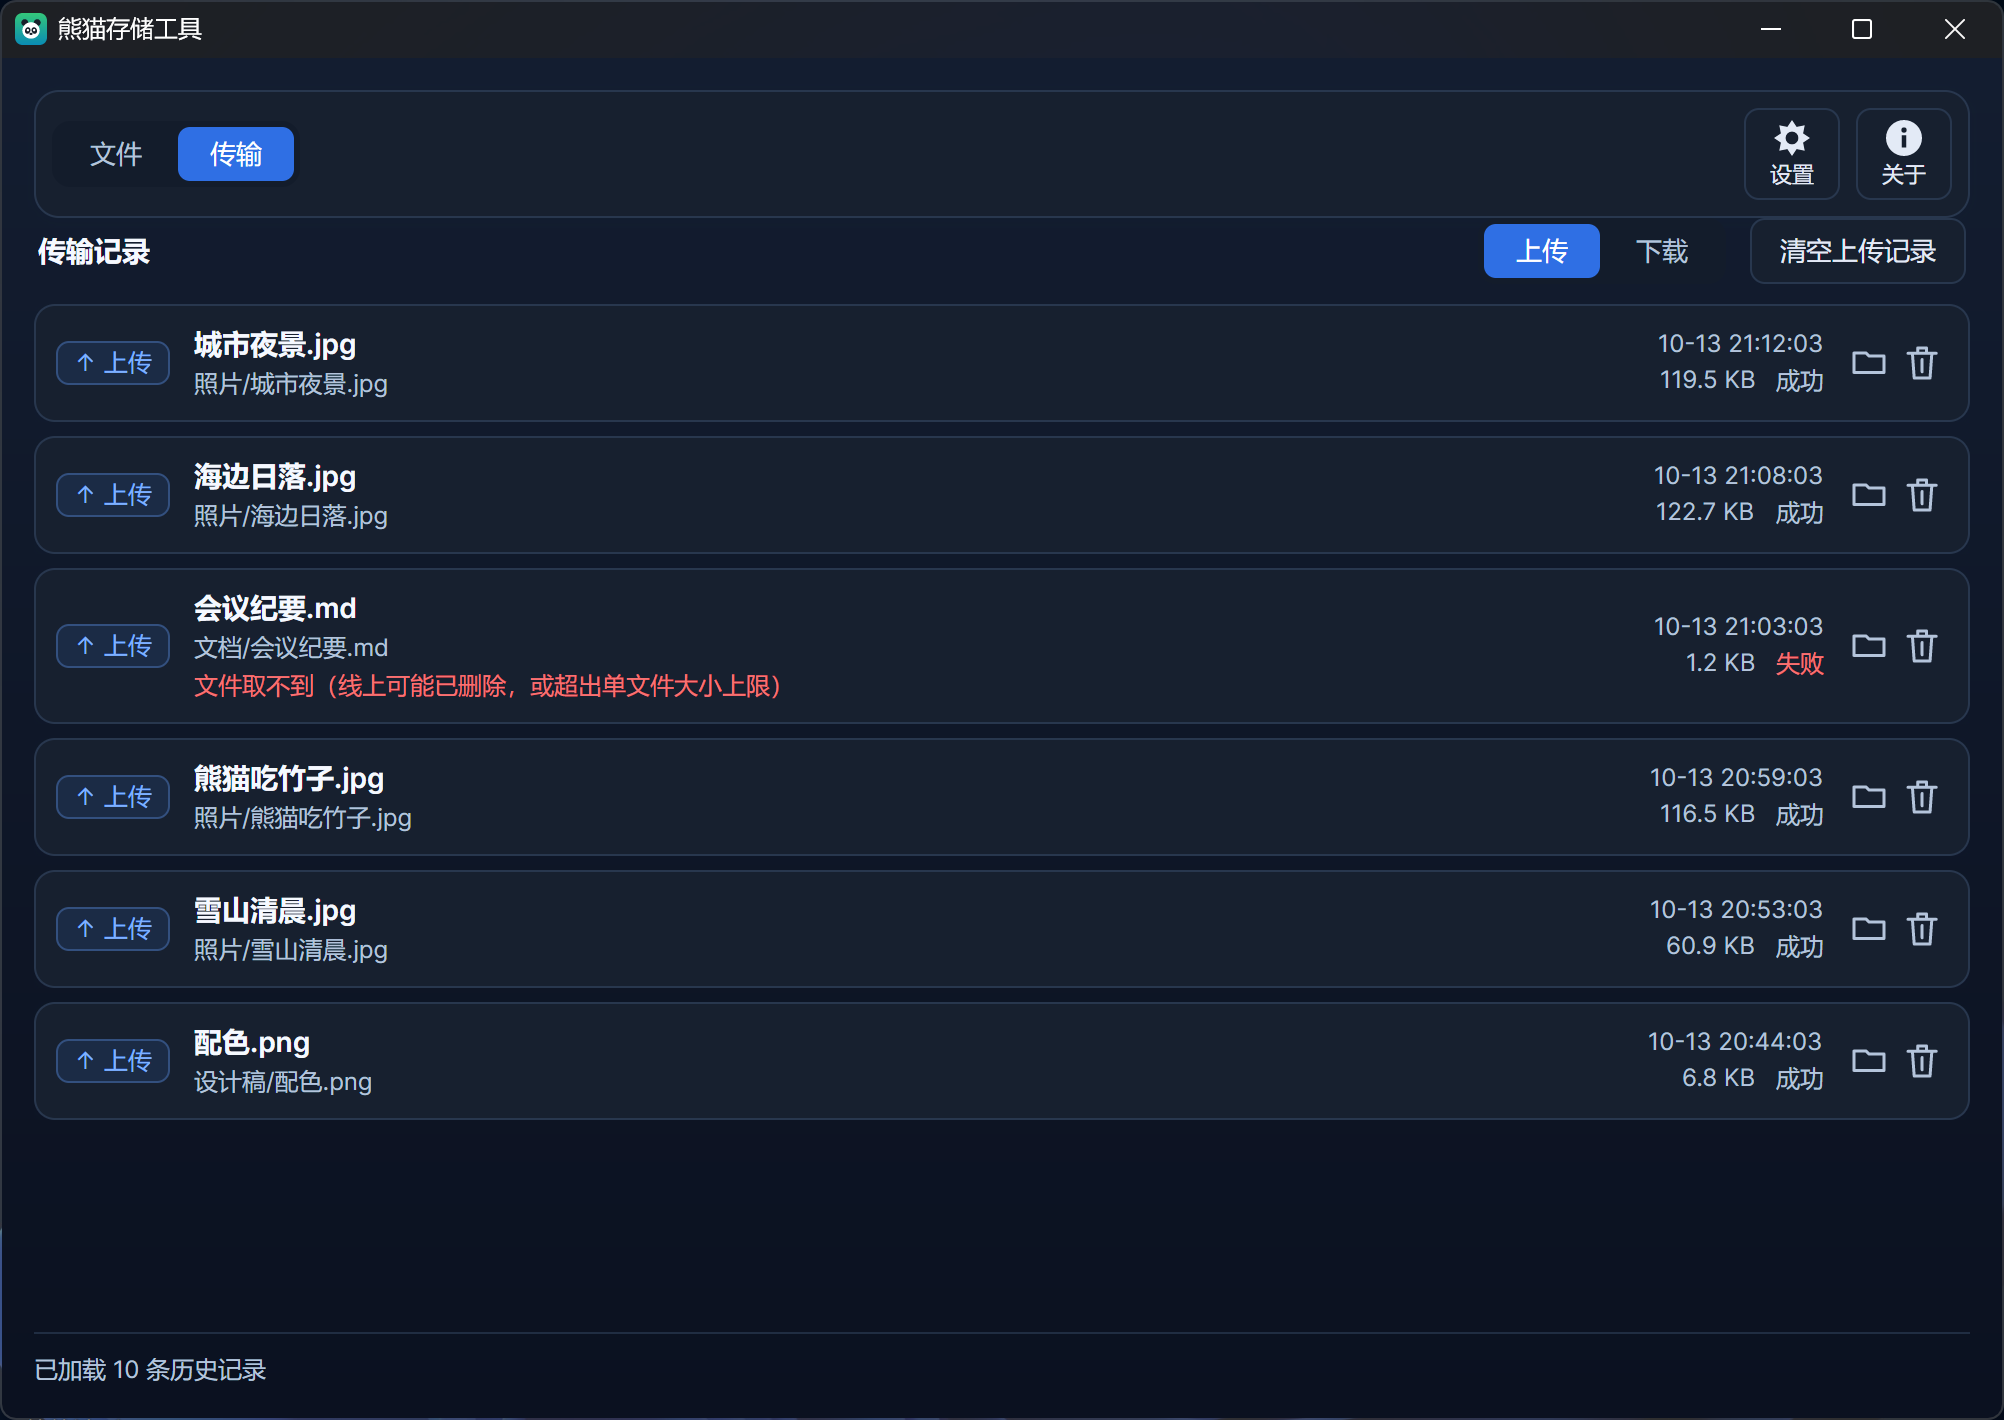
上传与下载都留痕,失败的还会写明原因(大部分失败其实是限流 —— 未认证请求 5000 次/小时):
还有一个不显眼的坑
上传文件夹是「一个文件一次提交」。文件多的时候既慢、又容易撞上限流。 要合并成一次提交就得走 Git Data API(建 tree → 建 commit → 更新 ref), 那是另一套完全不同的接口,代价不小。